Studie · 7. Oktober 2026
Wer wird in deutschen KI-Antworten zitiert?
Wir haben 51.502 Quellenangaben von ChatGPT, Perplexity, Google AI Overviews, Gemini, Claude und Grok zu deutschen Kauffragen in 17 Branchen gemessen. Es dominiert Kaufberatung vor Journalismus. Vor allem Berichte über Testergebnisse aus zweiter Hand finden viel Erwähnung. Wir ermitteln, warum die KI so gerne nach dem Testsieger sucht.
KI-Systeme wie ChatGPT, Perplexity und Googles AI Overviews beantworten Kauffragen inzwischen direkt, mit wenigen ausgewählten Quellen statt einer Trefferliste. Welche Quellen sie wählen, entscheidet mit darüber, welche Marken, Tests und Medien bei Verbrauchern ankommen. Für den deutschen Markt gab es dazu bisher keine systematische Messung; die großen Studien beruhen auf englischen Anfragen in den USA.
Wir haben über einen Monat deutsche Kauf- und Empfehlungsfragen ohne Markennamen an zehn KI-Kanäle gestellt und alle Quellen ausgewertet, die sechs Systeme mit Websuche im Antworttext zitieren: 51.502 Zitate aus 7.719 Antworten in 17 Branchen, jede Quelle einer von zehn Quellenarten zugeordnet.
- 65 %der Antworten von Claude, Gemini und Grok auf Kauffragen ohne das Wort „Test“ enthalten mindestens eine eigene Suchanfrage nach Tests: Die Systeme formen die Frage in ihren Fan-out-Queries selbst um. Bei Hintergrundfragen zu denselben Themen sind es 4 % (Kontrollmessung, ein Lauf).
- 78 %der Verlagszitate führen zu Kaufberatung, Vergleichen oder Berichten über Testergebnisse, 22 % zu klassischem Journalismus.
- 64 %der Zitate zu Ergebnissen der Stiftung Warentest und von Öko-Test gehen an Nacherzählungen Dritter, nicht an das Original; zählt jede Branche gleich, 51 %. 71 % der Antworten mit solchem Zitat stützen sich zumindest auch auf eine Nacherzählung.
- 99 %Originalzitate bei ChatGPT im Fall Tiefkühlpizza, bei Gemini 0 %. Jedes System hat eigene Quellenvorlieben.
- 103von 51.502 Zitaten entfallen auf Wikipedia, in US-Studien die meistzitierte Quelle. Häufigste Einzelquelle ist hier test.de, die Website der Stiftung Warentest, vor chip.de und YouTube.
- 36/71Verlage mit zitierter Kaufberatung behalten sich Text- und Data-Mining vor. Googles AI Overviews zitieren viele von ihnen trotzdem: Für sie gilt nach Googles Angaben nicht die Sperre Google-Extended, sondern die Snippet-Steuerung der Google-Suche.
Direkt zu den ErgebnissenKostenlos testen
Inhalt
1Warum die Quellen zählen
Wer bis vor Kurzem wissen wollte, welche Matratze, welches Girokonto oder welche Tiefkühlpizza gut ist, bekam von einer Suchmaschine zehn Links und entschied selbst, welchem er folgt. KI-Systeme nehmen diese Entscheidung vorweg. Sie lesen einige Seiten, fassen zusammen und nennen dazu eine Handvoll Quellen. Im Mittel sind es nach einer großen US-Studie 3,4 Domains je Antwort, bei klassischer Suche 7,3 [1].
Damit wird die Auswahl der Quellen selbst zur Nachricht. Für Marken bestimmt sie, ob und wie sie in einer Empfehlung vorkommen. Für Verlage entscheidet sie darüber, ob ihre Arbeit noch gelesen oder nur noch zusammengefasst wird. Für Testinstitutionen wie die Stiftung Warentest steht auf dem Spiel, ob ihr Urteil mit ihrem Namen ankommt oder in der Fassung anderer. Und für Verbraucher ist die Frage schlicht: Worauf beruht die Antwort, die ich bekomme?
Diese Studie misst das für Deutschland. Sie fragt, welche Arten von Quellen KI-Systeme bei deutschen Kauffragen zitieren, wie sich die Systeme darin unterscheiden, und was mit den Ergebnissen unabhängiger Tests geschieht, wenn eine KI sie weitergibt.
2Stand der Forschung
Die Quellenwahl generativer Suchsysteme ist seit 2025 Gegenstand mehrerer großer Studien, alle bislang als Preprints veröffentlicht. Zhang et al. werteten 1,4 Millionen Zitate aus 55.936 englischen Anfragen an sechs KI-Suchsysteme aus: Die Systeme zitieren weniger, aber vielfältigere Domains als klassische Suche, und ChatGPT greift häufiger zu Originalquellen wie Reuters und AP [1]. Huang et al. zeigen an 11.000 Anfragen, dass Wikipedia in allen Systemen die meistzitierte Quelle ist und dass zitiert nicht gleich genutzt heißt: Soziale Quellen werden zitiert, fließen aber deutlich weniger in den Text ein [2]. Chen et al. finden bei Kaufabsicht einen hohen Anteil von Markenquellen und zeigen, dass bei bekannten Marken das Vortraining die Antwort prägt, bei Nischen die aktuelle Suche [3].
Für diese Studie besonders wichtig ist die Arbeit von Grossman et al.: Websites, die Googles Crawler Google-Extended sperren, werden von Gemini und von Googles AI Overviews signifikant seltener genutzt; 21 große Verlage mit dieser Sperre wurden von Gemini nie zitiert. Außerdem schwanken AI Overviews zwischen zwei Läufen derselben Anfrage stärker als die klassische Suche [4]. Ma et al. zeigen, dass generative Suche Text bevorzugt, der für das zugrunde liegende Sprachmodell gut vorhersagbar ist [5].
Die Lücke: Alle diese Arbeiten messen englische Anfragen an Standorten in den USA. Eine mehrsprachige Studie zu Gesundheitsfragen zeigt, dass dieselbe Anfrage in der Landessprache 3,5- bis 13,5-mal mehr lokale Quellen liefert; Deutsch war dort nicht enthalten [7]. Eine vergleichbare Studie mit deutschen Anfragen über mehrere Branchen und Systeme haben wir nicht gefunden.
3Methode
3.1Fragen und Branchen
Gemessen wurden 17 Konsum- und Dienstleistungsbranchen: Banken, E-Bikes, Elektroautos, Gesichtspflege, Heißluftfritteusen, KI-Sichtbarkeits-Tools, Kaffeevollautomaten, Kindermode, Kinderwagen, Luxus-Uhren, Matratzen, Proteinpulver, Reis, Sportwagen, Spritpreisvergleich, Tee, Tiefkühlpizza. Je Branche stellten wir 20 bis 33 Fragen, wie sie Verbraucher vor einem Kauf stellen, etwa „Welche Matratzen-Marken haben das beste Preis-Leistungs-Verhältnis?" oder „Welche Bank würdest du empfehlen?". Keine Frage nennt eine Marke; so zeigt die Antwort, wen die KI von sich aus heranzieht. Die Fragen folgen festen Arten (Rangfolge, Empfehlung, Merkmal, Entdeckung) und sind über alle Läufe zeichengleich. Die Zahl der Fragen und Läufe je Messprojekt steht im Anhang.
3.2KI-Systeme und Messung
Jede Frage ging an zehn KI-Kanäle: ChatGPT, Gemini, Claude und Grok jeweils einmal ohne und einmal mit Websuche, dazu Perplexity und Google AI Overviews. Jede Anfrage enthielt die Anweisung, auf Deutsch für Verbraucher in Deutschland zu antworten; wo der Dienst es erlaubt, war der Standort Deutschland gesetzt. Quellen liefern nur die sechs Kanäle mit Websuche; sie sind die Grundlage dieser Studie. Gemessen wurde zwischen dem 5.9.2026 und dem 5.10.2026 in 3 bis 9 Läufen je Messprojekt. In zwölf Branchen kamen ChatGPT, Claude und Grok mit Suche erst am 27.9. hinzu; der Stichtagslauf am 3./4.10. maß alle Branchen in allen Kanälen mit denselben Fragen zur selben Zeit. Modelle und Zugangswege stehen in Tabelle A2 im Anhang; während des Messzeitraums haben wir kein Modell gewechselt. Jede Rohantwort ist gespeichert; alle Zahlen dieser Studie lassen sich bis zur einzelnen Antwort zurückverfolgen.
3.3Was als Zitat zählt
Viele Systeme liefern neben der Antwort eine Liste von Suchtreffern mit, von denen sie nur einen Teil tatsächlich verwenden. Wir zählen nur Zitate: Quellen, die im Antworttext verlinkt oder mit einer Fußnote belegt sind. Von 111.154 vorgelegten Quellen waren das 51.502 (46 %). Wer beides zusammenzählt, misst Treffer mit, die keine Rolle für die Antwort spielten.
3.4Einordnung der Quellen
Jede zitierte Domain wurde einer Quellenart zugeordnet: unabhängiger Verbrauchertest, Test- und Vergleichsportal, Verlag, öffentlich-rechtlicher Rundfunk, Plattform und Community, Händler und Hersteller, Fachportal und Blog, Behörde und Verband, die Website einer Marke, die in derselben Antwort genannt wird (ob wir sie messen oder nicht), und Longtail für alle nicht einzeln eingeordneten Domains. Verlagsdomains trennen wir zusätzlich nach der Adresse der zitierten Seite: Kaufberatung und Vergleich (etwa /vergleich/, /kaufkompass/), Berichte über Ergebnisse der Stiftung Warentest oder von Öko-Test, und klassischer Journalismus.
Die Zuordnung der Domains wurde doppelt gelesen. Zweiter Leser war ein Sprachmodell (Claude), das alle damals eingeordneten Domains blind, ohne Kenntnis der ersten Fassung, zuordnete. Die Übereinstimmung lag bei 78 % der Domains und 88 % der Zitate, Cohens Kappa 0,74, was als substanzielle Übereinstimmung gilt. Streitfälle wurden von Hand mit Begründung entschieden; danach wurden weitere Domains aus dem Longtail von Hand zugeordnet, ohne zweite Lesung. Die Trennung der Verlagsseiten nach Adresse (Kaufberatung, Testbericht, Journalismus) folgt festen Regeln und ist nicht doppelt gelesen. Heute sind 481 Domains eingeordnet; sie decken 72 % der Zitate ab.
3.5Gewichtung
Jede Branche zählt gleich, sonst bestimmte die Branche mit den meisten Läufen das Ergebnis. Weil Perplexity allein 32 % der Zitate liefert, rechnen wir die Kernaussagen zusätzlich mit gleichem Gewicht je Kanal gegen. Vergleiche zwischen Systemen beruhen nur auf den Branchen, in denen alle sechs Suchkanäle gemessen wurden (Banken, E-Bikes, Elektroautos, Heißluftfritteusen, KI-Sichtbarkeits-Tools, Kaffeevollautomaten, Kindermode, Kinderwagen, Luxus-Uhren, Matratzen, Proteinpulver, Reis, Sportwagen, Spritpreisvergleich, Tee, Tiefkühlpizza); sonst verglichen sie Branchen statt Systeme. Als Gegenprobe rechnen wir den Vergleich zusätzlich nur auf dem Stichtagslauf. Die Echokammer (Abschnitt 4.5) weisen wir je Zitat, je Branche gleich gewichtet und je Antwort aus.
3.6Echokammer
Für die Frage, ob die KI Testergebnisse aus erster oder zweiter Hand zitiert, zählen wir Zitate auf test.de und oekotest.de als Original und jede andere zitierte Seite, deren Adresse die Stiftung Warentest oder Öko-Test nennt, als Nacherzählung. Die Zuordnung beruht allein auf der Adresse; ob eine Seite das Ergebnis tatsächlich wiedergibt, haben wir nicht einzeln geprüft. Nacherzählungen ohne diesen Hinweis in der Adresse fehlen, Seiten, die den Test nur erwähnen, zählen mit.
3.7Umgang mit Rechten
Alle Zitatzahlen stammen aus den gespeicherten Antworten der KI-Systeme, nicht aus den zitierten Seiten. Wo wir Seiten selbst angesehen haben, haben wir vorher geprüft, ob sich der Anbieter Text- und Data-Mining nach § 44b UrhG vorbehält. Die Website der Stiftung Warentest haben wir wegen ihres ausdrücklichen Vorbehalts nicht automatisiert abgerufen; den Befund zur Bezahlschranke stützt eine Ansicht von Hand. Von Verlagen mit Vorbehalt wurden nur Angaben verwendet, die jeder Leser auf der Seite sieht; Rohkopien wurden nach der Auswertung gelöscht.
4Ergebnisse
4.1Was zitiert wird
Die größte eingeordnete Quellenart sind die Kaufberatungsseiten der Verlage. Zusammen mit ihren Berichten über Testergebnisse und dem klassischen Journalismus kommen Verlage auf 22 % aller Zitate, davon 78 % Service und 22 % klassischer Journalismus. Zählt jeder Kanal gleich, sind es 77 % Service; die Aussage hängt nicht an der großen Zitatmenge eines Systems. Zwischen Branchen und Messtagen streut der Wert deutlich: im Median 85 %, in der mittleren Hälfte zwischen 45 % und 93 % (77 Kombinationen aus Branche und Messtag mit mindestens 20 Verlagszitaten). 30 % der Zitate verteilen sich auf rund 4.005 weitere Domains, die jede für sich selten vorkommen (Longtail).
4.2Jedes System hat eigene Quellen
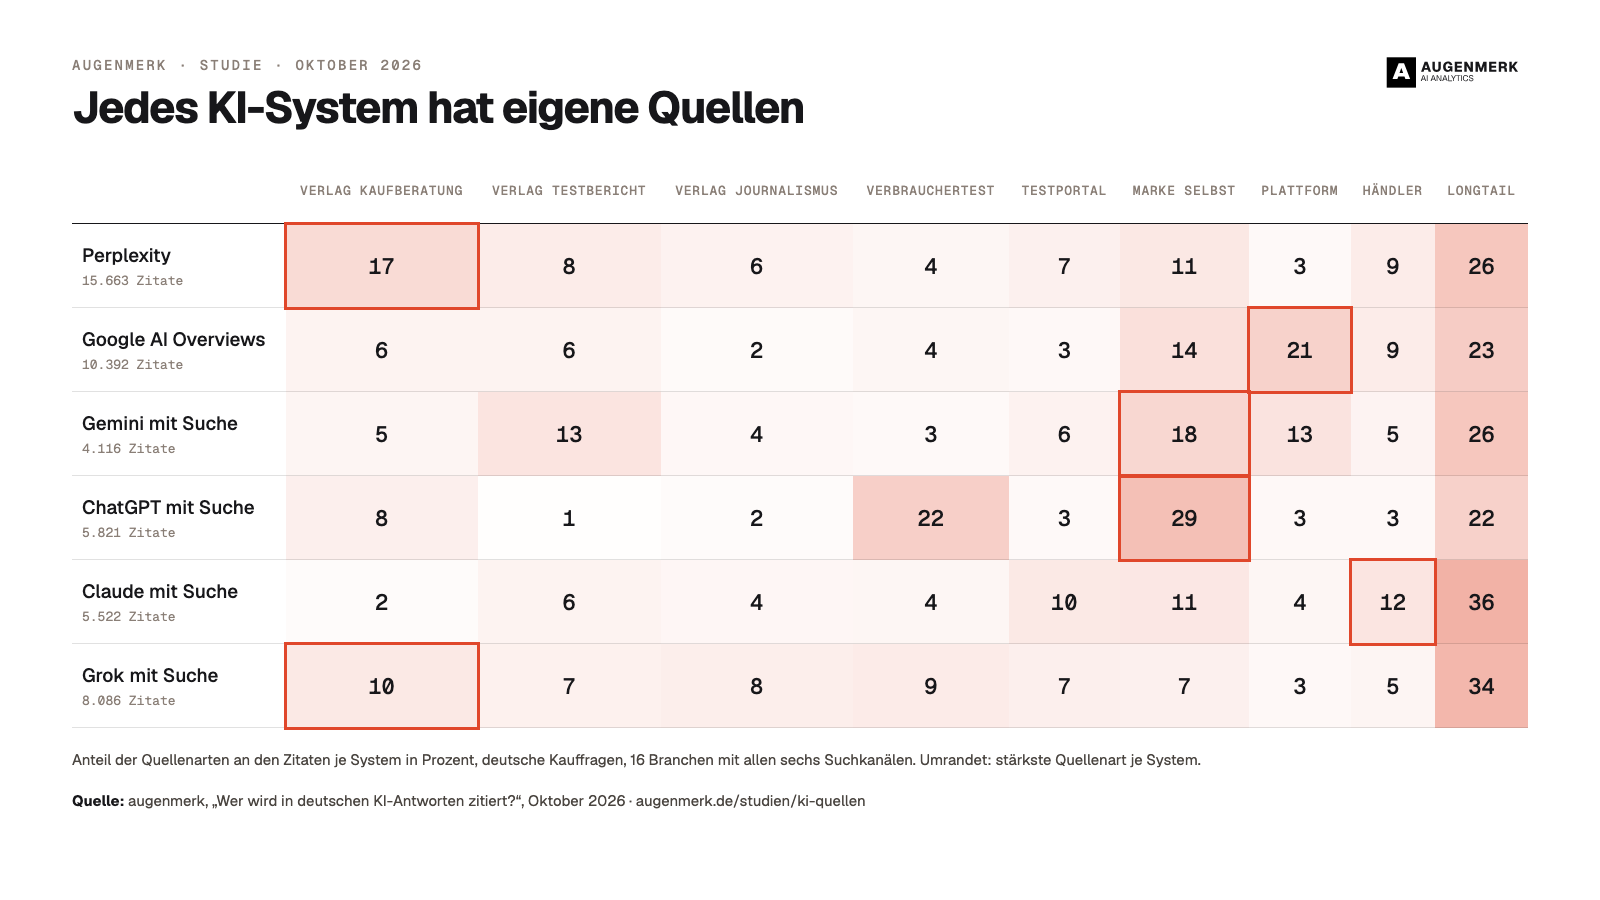
Auf den vollständig gemessenen Branchen unterscheiden sich die Systeme deutlich. ChatGPT zitiert am häufigsten die Websites der Marken, die es nennt (29 %), gleich danach unabhängige Verbrauchertests (22 %); kein anderes System stützt sich so stark auf Verbrauchertests (höchstens 9 %). Google AI Overviews greift zuerst zu YouTube, Reddit und anderen Plattformen (21 %). Perplexity stützt sich am stärksten auf die Verlage, auf Kaufberatung und Testberichte (25 %). Gemini zitiert am häufigsten die Website der Marke selbst (18 %). Claude verteilt sich ohne klaren Schwerpunkt auf Händler, Testportale und Markenseiten (je 10 bis 12 %). Klassischen Verlagsjournalismus zitieren Grok (8 %) und Perplexity (6 %) am ehesten, die übrigen Systeme höchstens 4 %. Dasselbe Muster zeigen die US-Studien: ChatGPT zieht Originalquellen vor [1], Googles Systeme Plattformen [2].
Gegenprobe Stichtag. Weil drei Kanäle in zwölf Branchen erst später hinzukamen, haben wir den Vergleich nur auf dem Stichtagslauf wiederholt, mit denselben Fragen zur selben Zeit in allen 17 Branchen (14.078 Zitate). Das Muster hält: ChatGPT zitiert am häufigsten Markenseiten (35 %) und Verbrauchertests (21 %), Google AI Overviews Plattformen (22 %), Perplexity die Kaufberatung der Verlage (20 %), Gemini die Markenseiten (18 %).
| Verlag Kaufberatung | Verlag Testbericht | Verlag Journalismus | Verbrauchertest | Testportal | Marke selbst | Plattform | Händler | Longtail | |
|---|---|---|---|---|---|---|---|---|---|
| Perplexity15.663 Zitate | 17 | 8 | 6 | 4 | 7 | 11 | 3 | 9 | 26 |
| Google AI Overviews10.392 Zitate | 6 | 6 | 2 | 4 | 3 | 14 | 21 | 9 | 23 |
| Gemini mit Suche4.116 Zitate | 5 | 13 | 4 | 3 | 6 | 18 | 13 | 5 | 26 |
| ChatGPT mit Suche5.821 Zitate | 8 | 1 | 2 | 22 | 3 | 29 | 3 | 3 | 22 |
| Claude mit Suche5.522 Zitate | 2 | 6 | 4 | 4 | 10 | 11 | 4 | 12 | 36 |
| Grok mit Suche8.086 Zitate | 10 | 7 | 8 | 9 | 7 | 7 | 3 | 5 | 34 |
4.3Die meistzitierten Domains
Die meistzitierte Einzelquelle ist test.de, die Website der Stiftung Warentest: Sie steht in 18 % der Antworten mit Zitat, getragen vor allem von ChatGPT. Es folgen chip.de und YouTube, das als einzige Domain in allen 17 Branchen vorkommt (11 %). Wikipedia, in den US-Studien die meistzitierte Quelle, spielt keine Rolle: 103 von 51.502 Zitaten.
| # | Domain | Art | Antworten | Branchen |
|---|---|---|---|---|
| 1 | test.de | Verbrauchertest | 18,3 % | 14 / 17 |
| 2 | chip.de | Verlag | 12,4 % | 16 / 17 |
| 3 | youtube.com | Plattform | 10,6 % | 17 / 17 |
| 4 | rtl.de | Verlag | 7,0 % | 13 / 17 |
| 5 | welt.de | Verlag | 6,1 % | 15 / 17 |
| 6 | adac.de | Verbrauchertest | 6,0 % | 6 / 17 |
| 7 | bild.de | Verlag | 5,7 % | 14 / 17 |
| 8 | produkte-im-test.de | Testportal | 5,4 % | 8 / 17 |
| 9 | testberichte.de | Testportal | 5,4 % | 13 / 17 |
| 10 | faz.net | Verlag | 5,2 % | 13 / 17 |
| 11 | businessinsider.de | Verlag | 4,9 % | 12 / 17 |
| 12 | utopia.de | Verlag | 4,9 % | 12 / 17 |
| 13 | vergleich.org | Testportal | 4,5 % | 11 / 17 |
| 14 | reddit.com | Plattform | 4,4 % | 16 / 17 |
| 15 | pedali.de | Händler | 4,1 % | 1 / 17 |
| 16 | t-online.de | Verlag | 4,0 % | 15 / 17 |
| 17 | imtest.de | Verlag | 3,5 % | 9 / 17 |
| 18 | oekotest.de | Verbrauchertest | 3,4 % | 8 / 17 |
| 19 | merkur.de | Verlag | 3,3 % | 12 / 17 |
| 20 | coffeeness.de | Fachportal | 3,3 % | 2 / 17 |
4.4Verlage: Service statt klassischer Journalismus
Bei den großen Verlagsmarken führt die Mehrheit der zitierten Adressen zu Kaufberatung oder Testberichten. Die Rubriken tragen Namen wie „Vergleiche", „Kaufberater", „Insider Picks" oder „Kaufkompass". Klassischer Journalismus wird seltener zitiert, am ehesten bei Grok und Perplexity.
Der Fall FAZ. Von 42 zitierten FAZ-Adressen gehören 36 zum „Kaufkompass". Die FAZ sperrt in ihrer robots.txt 10 KI-Crawler, darunter Google-Extended und PerplexityBot, und behält sich Text- und Data-Mining vor. Gemini zitiert sie in unseren Daten nie, was zum Befund von Grossman et al. passt [4]. Google AI Overviews dagegen 87-mal: Für sie gilt Google-Extended nach Googles Angaben nicht. Begrenzen lassen sie sich nur über die Snippet-Vorgaben der Google-Suche (nosnippet, data-nosnippet, max-snippet), also um den Preis kürzerer oder fehlender Ausschnitte in der Suche selbst. Perplexity zitiert die FAZ 17-mal, obwohl ihr Crawler gesperrt ist; woher Perplexity die Seiten kennt, zeigen unsere Daten nicht. Zitiert wird von der FAZ also vor allem die Kaufberatung.
4.5Die Echokammer der Testergebnisse
Von allen Zitaten, die auf ein Ergebnis der Stiftung Warentest oder von Öko-Test verweisen, gehen 64 % an eine Nacherzählung auf einer anderen Website und 36 % an das Original (4.445 gegen 2.501 Zitate). Der Wert hängt stark an einzelnen Branchen, vor allem an der Tiefkühlpizza: Zählt jede Branche mit mindestens 20 solchen Zitaten gleich, sind es 51 % (13 Branchen). Je Branche und Messtag liegt der Anteil im Median bei 64 %, in der mittleren Hälfte zwischen 47 % und 78 % (50 Kombinationen).
Je Antwort gerechnet. 2.656 Antworten zitieren mindestens einmal Original oder Nacherzählung. 41 % davon stützen sich nur auf Nacherzählungen, 30 % auf beides, 29 % nur auf das Original. In 71 % der Antworten mit Testbezug steckt also mindestens eine Nacherzählung.
Die Systeme unterscheiden sich dabei stark: Bei Tiefkühlpizza zitiert ChatGPT in 99 % der Fälle das Original, Gemini in 0 %.
| Branche | Original | Nacherzählung | Echo | Erzähler |
|---|---|---|---|---|
| Tiefkühlpizza | 493 | 1656 | 77 % | 40 |
| Reis | 408 | 900 | 69 % | 46 |
| Kinderwagen | 325 | 347 | 52 % | 35 |
| Tee | 260 | 307 | 54 % | 33 |
| Heißluftfritteusen | 303 | 263 | 46 % | 30 |
| Matratzen | 199 | 364 | 65 % | 49 |
| Gesichtspflege | 122 | 201 | 62 % | 39 |
| Kaffeevollautomaten | 111 | 138 | 55 % | 22 |
| Proteinpulver | 38 | 161 | 81 % | 14 |
| Banken | 60 | 57 | 49 % | 13 |
| Kindermode | 94 | 20 | 18 % | 14 |
| E-Bikes | 60 | 31 | 34 % | 8 |
| Spritpreisvergleich | 27 | 0 | 0 % | 0 |
Beispiel Tiefkühlpizza. Unter den meistzitierten Verlagsseiten stehen 9 Nacherzählungen desselben Warentest-Tests. 7 davon erschienen innerhalb von elf Tagen im September 2024. Zwei Jahre später tragen sie in unseren Messungen zusammen 781 Zitate.
| Erschienen | Seite | Zitate |
|---|---|---|
| 17.9.2024 | bild.de | 61 |
| 18.9.2024 | t-online.de | 143 |
| 18.9.2024 | morgenpost.de | 44 |
| 18.9.2024 | spiegel.de | 27 |
| 19.9.2024 | freundin.de | 95 |
| 25.9.2024 | welt.de | 191 |
| 28.9.2024 | familie.de | 36 |
| 1.11.2024 | heidelberg24.de | 28 |
| ohne Datum | lecker.de | 156 |
4.6Mögliche Erklärungen für das Echo
Warum die Systeme so oft die Nacherzählung zitieren, lässt sich mit diesen Daten nicht beweisen. Mehrere Erklärungen liegen nahe; keine schließt die anderen aus.
Die Noten liegen hinter der Bezahlschranke. Auf der Testseite zur Tiefkühlpizza sind Qualitätsurteil, sensorisches Urteil, Ernährungsphysiologie, Schadstoffe und Mikrobiologie ohne Anmeldung für alle 21 Produkte gesperrt; das Freischalten kostet 4,90 €. Frei lesbar sind die Liste der Produkte und ein Einleitungstext. Die Nacherzählungen schreiben die Noten dagegen offen hin. In den Antworten selbst zeigt sich das kaum: Antworten, die nur Nacherzählungen zitieren, nennen ähnlich oft mindestens zwei konkrete Noten (146 von 404) wie Antworten mit test.de-Zitat (94 von 296).
Das Original liegt oft vor, wird aber seltener zitiert. Perplexity hatte test.de 998-mal als Suchtreffer vorliegen und zitierte es 377-mal. Warum ein Treffer nicht zitiert wird, zeigen die Daten nicht: Er kann gesperrt, unpassend oder für die Antwort weniger ergiebig gewesen sein.
| System | test.de vorgelegt | zitiert | Anteil |
|---|---|---|---|
| Grok mit Suche | 3425 | 689 | 20 % |
| Perplexity | 998 | 377 | 38 % |
Ein Teil der KI-Crawler ist ausgesperrt. Die robots.txt von test.de verbietet den Trainings- und Abruf-Crawlern von OpenAI, Anthropic und Google-Extended den Zugriff, lässt deren Such-Crawler aber zu. Das passt dazu, dass die ChatGPT-Suche das Original zitiert, und zum Befund von Grossman et al., nach dem Gemini Seiten mit gesperrtem Google-Extended seltener nutzt [4]. Dazu kommt die Umformung der Frage in Suchen nach dem Testsieger (Abschnitt 4.8), auf die Nacherzählungen gezielt antworten. Welche dieser Erklärungen wie viel trägt, können wir nicht trennen.
4.7Ein Blick auf die zitierten Seiten
Die 25 meistzitierten Verlagsseiten mit Kaufberatung oder Testbericht tragen 1.572 Zitate. Kauflinks konnten wir nur auf den 8 Seiten von Verlagen ohne TDM-Vorbehalt zählen. Darunter tragen 2 Vergleichsseiten zu Proteinpulver zehn und mehr Links zu Shops oder Partnerprogrammen (bis 51); die meistzitierte dieser 8 Seiten (welt.de, 191 Zitate) ist eine Nachricht über ein Testergebnis ohne Kauflinks. Für die übrigen 17 Seiten sagen wir dazu nichts. 8 der 25 Seiten nennen keine Person als Autor, keine kennzeichnet den Einsatz von KI. Eigene Tests behauptet kaum eine; eine Vergleichsseite schreibt ausdrücklich, sie folge „den Experten durch ihre aufwendige Recherche-Arbeit und Test-Analyse".
Auf 66 Vergleichsseiten von 19 Verlagen ohne Vorbehalt haben wir geprüft, ob verschiedene Verlage denselben Text verwenden. Das ist nicht der Fall: Die höchste wörtliche Überschneidung zwischen zwei Verlagen liegt bei 4.6 %, zwischen Titeln desselben Hauses. Innerhalb der Verlage folgen die Seiten dagegen festen Vorlagen über alle Produkte hinweg, etwa „Eiweißpulver Bestenliste 2026 / Was ist Eiweißpulver?" und „Tiefkühlpizza Bestenliste 2026 / Was ist eine Tiefkühlpizza?". Das zeigt Serienproduktion nach Schema; wer die Vorlagen füllt, zeigt es nicht.
Tabelle 5: die 25 Seiten im Einzelnen
| Seite | Titel | Zitate | Kauflinks | Hinweis | Erschienen / Stand |
|---|---|---|---|---|---|
| welt.de | Tiefkühlpizza im Test: Diese Marken schneiden bei Stiftung Warentest am | 191 | – | – | 25.9.2024 |
| lecker.de | Tiefkuehlpizza bei stiftung warentest welche salami pizza schneidet am b | 156 | n. a. | – | – |
| t-online.de | Supermarkt die beste tiefkuehlpizza laut stiftung warentest | 143 | n. a. | – | 18.9.2024 |
| chip.de | Tank-Apps im Vergleich: Diese sollten Sie kennen - CHIP | 126 | n. a. | ja | 21.4.2026 |
| freundin.de | Nicht dr oetker ist beste tiefkuehlpizza laut stiftung warentest | 95 | – | – | 19.9.2024 |
| gaultmillau.at | ▷ Das sind die besten Tiefkühl-Pizzen - News - 2026 - Gault&Millau | 87 | n. a. | – | 26.2.2024 |
| chip.de | Proteinpulver-Test 2026: Qualität, Geschmack, Preis-Leistung - CHIP | 82 | n. a. | ja | 17.8.2026 |
| bild.de | Stiftung Warentest: Das sind die besten Tiefkühl-Pizzen | Leben & Wi | 61 | – | – | 17.9.2024 |
| rtl.de | 🥇 Modelle, 1 klarer Sieger: Eiweißpulver Test | rtl.de Vergleich | 56 | 3 | ja | 30.8.2026 |
| chip.de | Die beste Tiefkühlpizza in der CHIP-Leserumfrage - CHIP | 49 | n. a. | ja | 1.10.2020 |
| gq-magazin.de | Whey Protein Test 2026: Die 10 besten Proteinpulver – wirklich getestet | 48 | 30 | ja | 15.5.2021 |
| merkur.de | Der beste Reis – diese Marken enthalten am wenigsten Schadstoffe | 46 | n. a. | – | 30.4.2026 |
| morgenpost.de | Stiftung Warentest fällt klares Urteil bei Tiefkühlpizza | 44 | – | – | 18.9.2024 |
| web.de | Tank-Apps im Vergleich: Mit diesen Helfern spart man an der Tankstelle | | 41 | n. a. | – | 10.8.2026 |
| chip.de | Erstaunliche Ergebnisse: Tiefkühl-Pizza mit Gemüse bei ÖKO-TEST - CHIP | 38 | n. a. | ja | 27.10.2024 |
| bild.de | Proteinpulver im Test: Welches Whey überzeugt? | BILD-Kaufberater | 38 | 51 | – | 18.12.2025 |
| familie.de | Tiefkühlpizza-Test: Die 4 Sieger bei Stiftung Warentest | 36 | n. a. | ja | 28.9.2024 |
| businessinsider.de | Matratze: Welche Marke ist am besten - Business Insider | 34 | n. a. | ja | 24.4.2026 |
| focus-mobility.de | Die besten E-Bike-Marken 2026 | 31 | – | – | – |
| chip.de | Tiefkühlpizza - dieser Klassiker enttäuscht im Vergleich - CHIP | 30 | n. a. | ja | 1.10.2021 |
| merkur.de | Tiefkühlpizza im Vergleich: Überraschung für Dr. Oetker-Fans - es gibt e | 30 | n. a. | – | 4.11.2020 |
| heidelberg24.de | Beste Tiefkühl-Pizza – Note „sehr gut“ ausgerechnet bei dieser Sorte | 28 | n. a. | – | 1.11.2024 |
| heidelberg24.de | Das beste Proteinpulver – der Testsieger ist überraschend günstig | 28 | n. a. | – | 20.5.2026 |
| spiegel.de | Stiftung Warentest zu Salami-Pizza: Von 21 getesteten Produkten sind elf | 27 | n. a. | – | 18.9.2024 |
| focus.de | Tiefkühl-Pizza-Test: Marken-Produkt enttäuscht - Aldi-Pizza überzeugt - | 27 | n. a. | – | 26.6.2023 |
17 Seiten stammen von Verlagen mit TDM-Vorbehalt oder unlesbarer Erklärung; dort sind nur sichtbare Angaben erfasst, Kauflinks nicht ausgewertet (n. a.). Kursive Titel: aus der Adresse abgeleitet, weil kein Seitentitel erfasst wurde. Datum: Erscheinungs- oder Aktualisierungsdatum, wie die Seite es angibt.
4.8Fan-out-Queries: Wonach die KI sucht
Bevor ein KI-System mit Websuche antwortet, fächert es die Frage in eigene Suchanfragen auf und liest, was die Suche liefert. Diese Suchanfragen heißen Fan-out-Queries: Aus einer Frage werden mehrere Suchen, und erst deren Treffer entscheiden, welche Quellen die Antwort überhaupt sehen kann. Claude, Gemini und Grok legen ihre Fan-out-Queries offen. Wir haben 8.100 Fan-out-Queries aus 3.199 Antworten ausgewertet. Sie zeigen, was die Systeme suchen, bevor sie Quellen auswählen: Die Systeme formen offene Kauffragen in Suchen nach Tests und Bestenlisten um, auch wenn niemand nach einem Test gefragt hat.
In 65 % der Antworten auf Fragen, in deren Wortlaut „Test“ nicht vorkommt, sucht das System nach Tests, in 37 % ausdrücklich nach der Stiftung Warentest oder Öko-Test, in 12 % nach dem „Testsieger“. In 59 % hängt es eine Jahreszahl an, meist „2026“. Auf solche Anfragen antworten im Netz vor allem Seiten, die genau dafür geschrieben sind: Vergleichsrubriken der Verlage, Testportale und Nacherzählungen von Testergebnissen (Abschnitte 4.4 und 4.5).
| Frage | Fan-out-Queries des Systems |
|---|---|
| Welche Heißluftfritteusen-Marke würdest du für große Mengen empfehlen? Claude mit Suche | Heißluftfritteuse große Mengen Familie Test 2026 beste Heißluftfritteuse große Kapazität Liter Empfehlung |
| Welche Matratzen-Marke würdest du bei Rückenschmerzen empfehlen? Grok mit Suche | beste Matratze bei Rückenschmerzen Test Deutschland 2026 Stiftung Warentest Matratzen Test Rückenschmerzen empfohlene Matratzenmarken bei Rückenschmerzen DE |
| Welche Bank würdest du für eine kostenlose Debitkarte empfehlen? Claude mit Suche | kostenlose Debitkarte Bank Deutschland 2026 Vergleich beste kostenlose Girokonto Debitkarte ohne Gebühren 2026 |
| Wie gelangt Arsen in Reis? Claude mit Suche | Wie gelangt Arsen in Reis Arsen Reis Anbau Boden Grundwasser |
| Welche Matratze ist gerade im Hype? Claude mit Suche | welche Matratze ist gerade im Hype 2026 Matratzen Trend Testsieger Deutschland aktuell |
Wie stark die Umformung ist, hängt an der Art der Frage. Wer nach der besten Marke oder nach einer Empfehlung fragt, bekommt eine Testsuche; wer seinen Bedarf beschreibt, kaum.
| Frageart | Antworten | sucht „Test“ | sucht Warentest / Öko-Test |
|---|---|---|---|
| Rangfolge („Was sind die besten …?“) | 1.127 | 79 % | 54 % |
| Empfehlung („Welche … würdest du empfehlen?“) | 628 | 73 % | 44 % |
| Merkmal („Welche … hat das beste …?“) | 673 | 50 % | 22 % |
| Entdeckung („Welche Anbieter gibt es für …?“) | 201 | 21 % | 1 % |
| Bedarf („Worauf achte ich bei …?“) | 143 | 4 % | 4 % |
| System | Antworten | sucht „Test“ | mit Jahreszahl | Anfragen auf Englisch |
|---|---|---|---|---|
| Claude mit Suche | 1.231 | 70 % | 67 % | 2 % |
| Gemini mit Suche | 426 | 57 % | 2 % | 2 % |
| Grok mit Suche | 1.376 | 63 % | 69 % | 11 % |
4.9Gegenprobe: Hintergrund- und Trendfragen
Liegt der geringe Anteil des Journalismus an der Art unserer Fragen? Um das zu prüfen, haben wir am 2.10.2026 zwei Kontrollmessungen zu denselben 17 Themen angehängt, je ein Lauf in denselben Kanälen, nicht Teil der übrigen Zahlen: 85 Hintergrundfragen ohne Kaufabsicht („Wie gelangt Arsen in Reis?“, „Warum schwanken Benzinpreise mehrmals am Tag?“) und 51 Trendfragen („Welche Heißluftfritteuse ist gerade auf TikTok viral?“).
| Kauffragen | Hintergrund | Trend | |
|---|---|---|---|
| sucht „Test“ | 65 % | 4 % | 36 % |
| sucht nach Trend, TikTok, Instagram, YouTube | 0 % | 2 % | 100 % |
| Zitate: Kaufberatung, Testberichte, Testportale | 23 % | 2 % | 14 % |
| Zitate: klassischer Journalismus (Verlage und öffentlich-rechtlich) | 7 % | 14 % | 9 % |
| Zitate: Plattformen (YouTube, TikTok, Instagram, Reddit …) | 8 % | 6 % | 31 % |
| Zitate gesamt | 51.502 | 2.837 | 1.299 |
Ohne Kaufabsicht verschwindet die Testsuche, und mit ihr die Kaufberatung: Die Systeme suchen nur in 4 % der Antworten nach Tests, Kaufberatung und Testportale fallen auf 2 % der Zitate. Journalistische Angebote kommen auf mindestens 14 %, etwa doppelt so viel wie bei Kauffragen. Ebenso stark gewinnen Behörden, Verbraucherzentralen und Wissenschaft (bfr.bund.de, Umweltbundesamt, Bundesbank, PubMed u. a.): mindestens 12 % der Zitate, bei Kauffragen 0,3 %. Der Journalismus wird also auch hier nicht zur Hauptquelle; zwei Drittel der Zitate verteilen sich auf viele einzelne Fachseiten. Die Zuspitzung des Quellenbildes auf Testsieger geht also mit der Kauffrage und der Testsuche einher. Ein Beweis, dass die Umformung sie verursacht, ist das nicht: Die Kontrollfragen unterscheiden sich in mehr als dem Suchverhalten, und sie beruhen auf einem Lauf.
Wer nach dem Trend fragt, bekommt Plattformen. Alle Fan-out-Queries nehmen den Trend auf, ein gutes Drittel hängt trotzdem „Test“ oder „Testsieger“ an. Plattformen kommen auf 31 % der Zitate; tiktok.com wird 162-mal zitiert, vor allem von Google AI Overviews (80) und Claude (49), von ChatGPT 0-mal.
5Diskussion
Die Suche beginnt mit einer Umformung. Die Systeme machen in ihren Fan-out-Queries etwa aus „Welche Matratze würdest du empfehlen?“ die Suche „Stiftung Warentest Matratzen Testsieger aktuell“ (Gemini). Wer so sucht, findet vor allem Seiten, die für solche Suchen geschrieben sind. Vieles spricht dafür, dass damit ein guter Teil der Quellenwahl fällt, bevor ein Modell eine Seite liest: Wo sich messen lässt, was vorlag und was zitiert wurde, übernehmen Perplexity und Grok redaktionelle Artikel fast so oft wie Kaufberatungen. Sie kommen nur seltener in die engere Auswahl. Die Gegenprobe mit Hintergrundfragen passt dazu, ohne die Ursache zu beweisen (Abschnitt 4.9).
Bei Kauffragen zitiert die KI vor allem Service. Das ist bei dieser Art Frage naheliegend und kein Urteil über die Qualität der Seiten. Die These, KI-Systeme behandelten Leitmedien als Anker der Wahrheit, stimmt für deutsche Kauffragen nur in einem engen Sinn. Verlage werden oft zitiert, aber vor allem dort, wo sie wie Testportale schreiben. Für Verlage heißt das: Ihre Sichtbarkeit in KI-Antworten hängt an ihren Vergleichsrubriken, nicht an ihrem klassischen Journalismus.
Testergebnisse kommen oft aus zweiter Hand an. Ein Testergebnis, dessen Noten hinter einer Bezahlschranke liegen, erreicht Verbraucher in KI-Antworten häufig in der Fassung Dritter, teils Jahre nach dem Test (Tabelle 3). Das ist kein Vorwurf an eine Seite: Die Testinstitution schützt ihr Geschäftsmodell, die Verlage berichten über einen Test, und die KI zitiert, was ihre Suche findet. Dabei können die Aktualität und die Herkunft eines Urteils verloren gehen.
Welches System, welche Welt. Wer ChatGPT fragt, bekommt eher die Websites der empfohlenen Marken und Verbrauchertests im Original; wer Google AI Overviews fragt, eher Plattformen; wer Perplexity fragt, eher Verlagsservice. Für Marken heißt das: Eine einzige Kennzahl über alle Systeme verdeckt, wo sie tatsächlich fehlen. Für Nutzer heißt es, dass dieselbe Frage je nach System auf unterschiedlichen Grundlagen beantwortet wird [2].
Sperren wirken je System verschieden. Die Hälfte der Verlage behält sich Text- und Data-Mining vor, die meisten sperren einzelne KI-Crawler (60 von 71). Googles AI Overviews zitieren sie dennoch: Für sie gilt nach Googles Angaben nicht Google-Extended, sondern die Snippet-Steuerung der Suche. Wer die AI Overviews begrenzen will, begrenzt damit auch die eigenen Ausschnitte in der Google-Suche.
Wikipedia fehlt. Anders als in den US-Studien spielt Wikipedia bei deutschen Kauffragen keine Rolle. Das liegt vermutlich weniger an der Sprache als an der Art der Frage: Wer nach der besten Matratze fragt, bekommt Testportale, nicht Enzyklopädien. Die Toronto-Studie mit Kauffragen findet ebenfalls Testportale vorn [3].
Ein offener Punkt. Generative Suche bevorzugt Text, der für ein Sprachmodell gut vorhersagbar ist [5]. Die zitierten Vergleichsseiten folgen festen Vorlagen. Ob solche Seiten deshalb bevorzugt werden, und ob sie selbst maschinell entstehen, zeigen unsere Daten nicht; KI-Detektoren gaben für dieselben Seiten Werte zwischen 0 und 66 %. Wir halten das für eine Frage, die eine eigene Untersuchung verdient.
6Grenzen
- Stichprobe: 17 Konsumbranchen, deutsche Kauf- und Empfehlungsfragen, 3 bis 9 Läufe je Messprojekt. Für Wissens- und Hintergrundfragen gilt das Bild nicht (Abschnitt 4.9); dort zeigen US-Studien Wikipedia vorn [1, 2].
- Kanäle: Systemvergleiche beruhen auf den 16 Branchen, in denen alle sechs Suchkanäle Quellen lieferten (ohne Gesichtspflege, wo Gemini keine Quellen nennt). In zwölf Branchen wurden ChatGPT, Claude und Grok am 27.9. an den letzten Lauf angehängt; die Gegenprobe auf dem Stichtagslauf zeigt dasselbe Muster (Abschnitt 4.2).
- Streuung: Die Anteile schwanken zwischen Branchen und Messtagen deutlich (Abschnitte 4.1 und 4.5). Die Gesamtwerte beschreiben die Mitte, nicht jede einzelne Messung.
- Einordnung: 72 % der Zitate sind eingeordnet; der Longtail ist nicht einzeln geprüft. Die zweite Lesung übernahm ein Sprachmodell und betraf nur die Zuordnung der Domains, nicht die Trennung der Verlagsseiten nach Adresse. Verlagsseiten ohne sprechende Adresse zählen zum klassischen Journalismus, der Anteil der Kaufberatung dürfte daher eher unterschätzt sein.
- Echokammer: Original und Nacherzählung sind allein an der Adresse erkannt (Abschnitt 3.6); der Gesamtwert hängt stark an der Tiefkühlpizza.
- Fan-out-Queries: Nur Claude, Gemini und Grok legen ihre Fan-out-Queries offen; für ChatGPT, Perplexity und Google wissen wir nicht, wonach sie suchen. Die Kontrollmessungen beruhen auf je einem Lauf.
- Zitat ist nicht Einfluss: Wir messen, welche Quellen im Text belegt sind, nicht, wie stark sie die Antwort prägen [2, 6].
- Momentaufnahme: KI-Systeme ändern ihre Quellenwahl laufend. Die Zahlen gelten für September und Anfang Oktober 2026.
- Preprints: Die zitierten Studien sind noch nicht begutachtet.
Was Unternehmen tun können
Die Ergebnisse lassen sich in sechs Schritte übersetzen. Jeder beruht auf einem Befund dieser Studie.
- Nach System getrennt hinsehen. ChatGPT, Google, Perplexity und Gemini stützen sich auf verschiedene Quellen (Abschnitt 4.2). Eine Marke kann in einem System gut dastehen und im anderen fehlen. Wer nur eine Gesamtzahl kennt, sieht nicht, wo er ansetzen muss. Ebenso wichtig: Kennt das Modell die Marke aus seinem Gedächtnis, oder findet es sie nur, wenn es sucht? Beides verlangt unterschiedliche Maßnahmen.
- Die eigene Website zitierfähig machen. ChatGPT, Gemini und Claude zitieren oft die Website der Marke, über die sie gerade sprechen (29, 18 und 11 % ihrer Zitate); bei ChatGPT ist sie die häufigste Quellenart überhaupt. Zitiert wird, was eine Antwort liefert: ein klarer Satz mit Zahl und Stand in den ersten Zeilen, eine ehrliche Vergleichsseite, die auch die eigenen Schwächen nennt, offengelegte Methoden und Daten.
- Dort vorkommen, wo die KI liest. Die meisten Zitate gehen an Quellen, die über eine Marke schreiben: Verbrauchertests wie die Stiftung Warentest (18 % der Antworten), Test- und Vergleichsrubriken der Verlage, Testportale und YouTube (11 %), siehe Abschnitte 4.1 und 4.3. Welche Domains in der eigenen Branche zählen, unterscheidet sich stark; eine Liste der tatsächlich zitierten Quellen ist der bessere Ausgangspunkt als eine allgemeine PR-Liste.
- Testergebnisse lesbar machen. Zitiert werden Testergebnisse überwiegend in Nacherzählungen Dritter, teils Jahre alt (Abschnitt 4.5). Wer in einem Test gut abgeschnitten hat, sollte das Ergebnis mit Datum und Quelle auf der eigenen Seite nennen, im Rahmen der Lizenzbedingungen der Testinstitution.
- Crawler-Sperren bewusst setzen. Google-Extended steuert nach Googles Angaben die Nutzung durch Gemini, nicht die AI Overviews; diese folgen der Google-Suche und lassen sich nur über Snippet-Vorgaben wie
nosnippet,data-nosnippetodermax-snippetbegrenzen, mit Folgen für die Darstellung in der Suche. Die Such-Crawler von OpenAI, Perplexity und Anthropic entscheiden, ob deren Suchfunktionen eine Seite lesen können (Abschnitte 4.4 und 4.6). Ob die eigene robots.txt diese Crawler zulässt, sollte eine bewusste Entscheidung sein, keine Voreinstellung. - Wiederholt messen, nicht einmal. KI-Antworten schwanken zwischen zwei Läufen derselben Frage [4]; auch die Anteile dieser Studie streuen je Branche und Messtag deutlich (Abschnitte 4.1 und 4.5). Eine einzelne Messung zeigt eine Momentaufnahme; erst mehrere Läufe zeigen, ob sich etwas bewegt hat.
Die eigene Sichtbarkeit messen
augenmerk misst, wie KI-Systeme über eine Marke sprechen: in welchem Anteil der Antworten sie genannt wird, an welcher Stelle, in welchem Ton, getrennt nach allen zehn Kanälen und nach Gedächtnis und Suche, und auf welche Quellen sich jede Antwort stützt. Jede Aussage ist mit der Stelle aus der Antwort belegt. Dieselbe Technik liegt dieser Studie zugrunde.
Kostenlos testenPakete ansehen
Offenlegung: augenmerk verkauft Messungen dieser Art. Die Studie ist eine eigene Auswertung; Methode und Grenzen sind in den Abschnitten 3 und 6 beschrieben. Dieser Abschnitt ist eine Folgerung aus den Ergebnissen, kein Teil der Messung.
7Literatur
Alle Arbeiten an der Quelle geprüft (Abstract und Volltext), Stand 27.9.2026. Studien von Anbietern, die selbst KI-Sichtbarkeit verkaufen, sind bewusst nicht aufgeführt.
- [1] Zhang, P., Ye, Q., Peng, Z., Garimella, K., Tyson, G. (2025). Source Coverage and Citation Bias in LLM-based vs. Traditional Search Engines. arXiv:2512.09483. arxiv.org/abs/2512.09483
- [2] Huang, M., Goyal, A., Saha, K., Chandrasekharan, E. (2026). Answer Bubbles: Information Exposure in AI-Mediated Search. arXiv:2603.16138. arxiv.org/abs/2603.16138
- [3] Chen, M., Wang, X., Chen, K., Koudas, N. (2026). Navigating the Shift: A Comparative Analysis of Web Search and Generative AI Response Generation. arXiv:2601.16858. arxiv.org/abs/2601.16858
- [4] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. arxiv.org/abs/2604.27790
- [5] Ma, L., Qin, J., Xu, X., Tan, Y. (2025). When Content is Goliath and Algorithm is David: The Style and Semantic Effects of Generative Search Engine. arXiv:2509.14436. arxiv.org/abs/2509.14436
- [6] Kai, Z., Xinyue, H., Jingang, Y. (2026). From Citation Selection to Citation Absorption: A Measurement Framework for Generative Engine Optimization Across AI Search Platforms. arXiv:2604.25707. arxiv.org/abs/2604.25707
- [7] Zha, M., Chang, H.-C. H. (2026). Who Anchors AI Overviews in Health? Baidu, Google, and the Geography of Authority. arXiv:2609.06798. arxiv.org/abs/2609.06798
AAnhang
Messprojekte
| Messprojekt | Fragen | Läufe |
|---|---|---|
| Banken · Index | 24 | 4 |
| E-Bikes | 25 | 4 |
| Elektroautos | 20 | 4 |
| Gesichtspflege | 25 | 3 |
| Heißluftfritteusen | 25 | 4 |
| KI-Sichtbarkeits-Tools | 25 | 4 |
| Kaffeevollautomaten | 25 | 4 |
| Kindermode | 25 | 4 |
| Kinderwagen | 25 | 4 |
| Luxus-Uhren | 25 | 4 |
| Matratzen | 25 | 6 |
| Proteinpulver | 25 | 6 |
| Reis · Index | 25 | 4 |
| Sportwagen | 25 | 4 |
| Spritpreisvergleich | 33 | 9 |
| Tee | 31 | 4 |
| Tiefkühlpizza | 27 | 8 |
| Tiefkühlpizza · Index | 25 | 4 |
Messbedingungen
| Kanal | Zugang | Modell |
|---|---|---|
| ChatGPT ohne Suche | OpenAI API | gpt-5.5 |
| ChatGPT mit Suche | ChatGPT-App, abgerufen über DataForSEO (LLM Scraper) | Voreinstellung der App |
| Perplexity | Perplexity API | sonar |
| Gemini ohne und mit Suche | Gemini API, mit Suche: Google-Suche als Grundlage | gemini-3.7-flash |
| Claude ohne und mit Suche | abgerufen über DataForSEO (LLM Responses) | claude-sonnet-5 |
| Grok ohne und mit Suche | xAI API, mit Suche: Websuche | grok-4.3 |
| Google AI Overviews | Google-Ergebnisseite, Desktop, Deutschland, abgerufen über DataForSEO | – |
Daten und Nachvollziehbarkeit
Rohantworten, Zuordnungen und Auswertungsskripte liegen bei augenmerk und stehen für Rückfragen zur Verfügung. Die Einordnung aller Domains, die Entscheidungen der zweiten Lesung und die Prüfung der Vorbehalte sind dokumentiert.
Die Stiftung Warentest wurde vor der Veröffentlichung um eine Stellungnahme gebeten; bis Redaktionsschluss lag keine vor. Fragen zur Studie und zu den Daten: service@augenmerk.de
augenmerk · Hamburg · augenmerk.de
Zitiervorschlag: Wagner, O. (2026). Wer wird in deutschen KI-Antworten zitiert? augenmerk. https://www.augenmerk.de/studien/ki-quellen